英伟达发布Nemotron 3.5 Super VL多模态大模型,专为AI智能体优化,支持文本、图像、文档与视频理解
SmartHey10月16日消息,英伟达正式推出全新开放多模态大模型——Nemotron 3.5 Super VL,专为需持续运行、执行复杂多步骤任务的AI智能体设计。
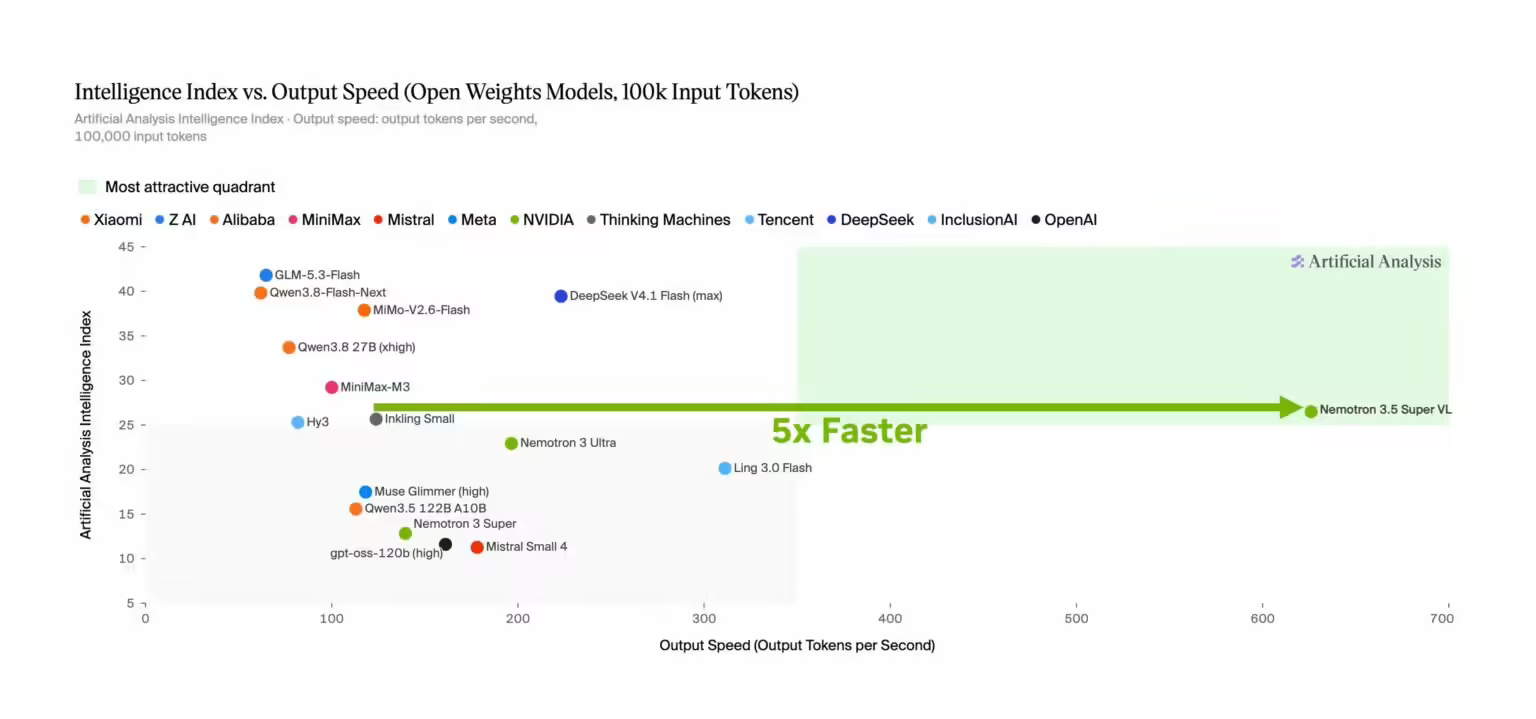
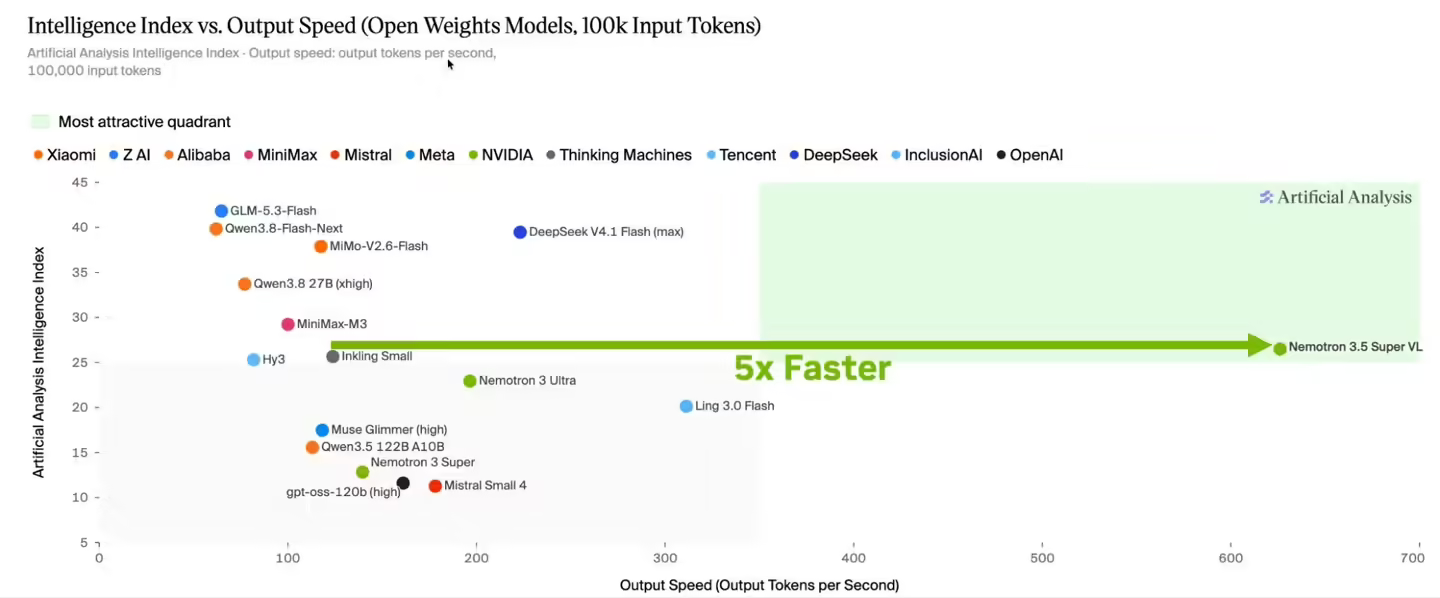
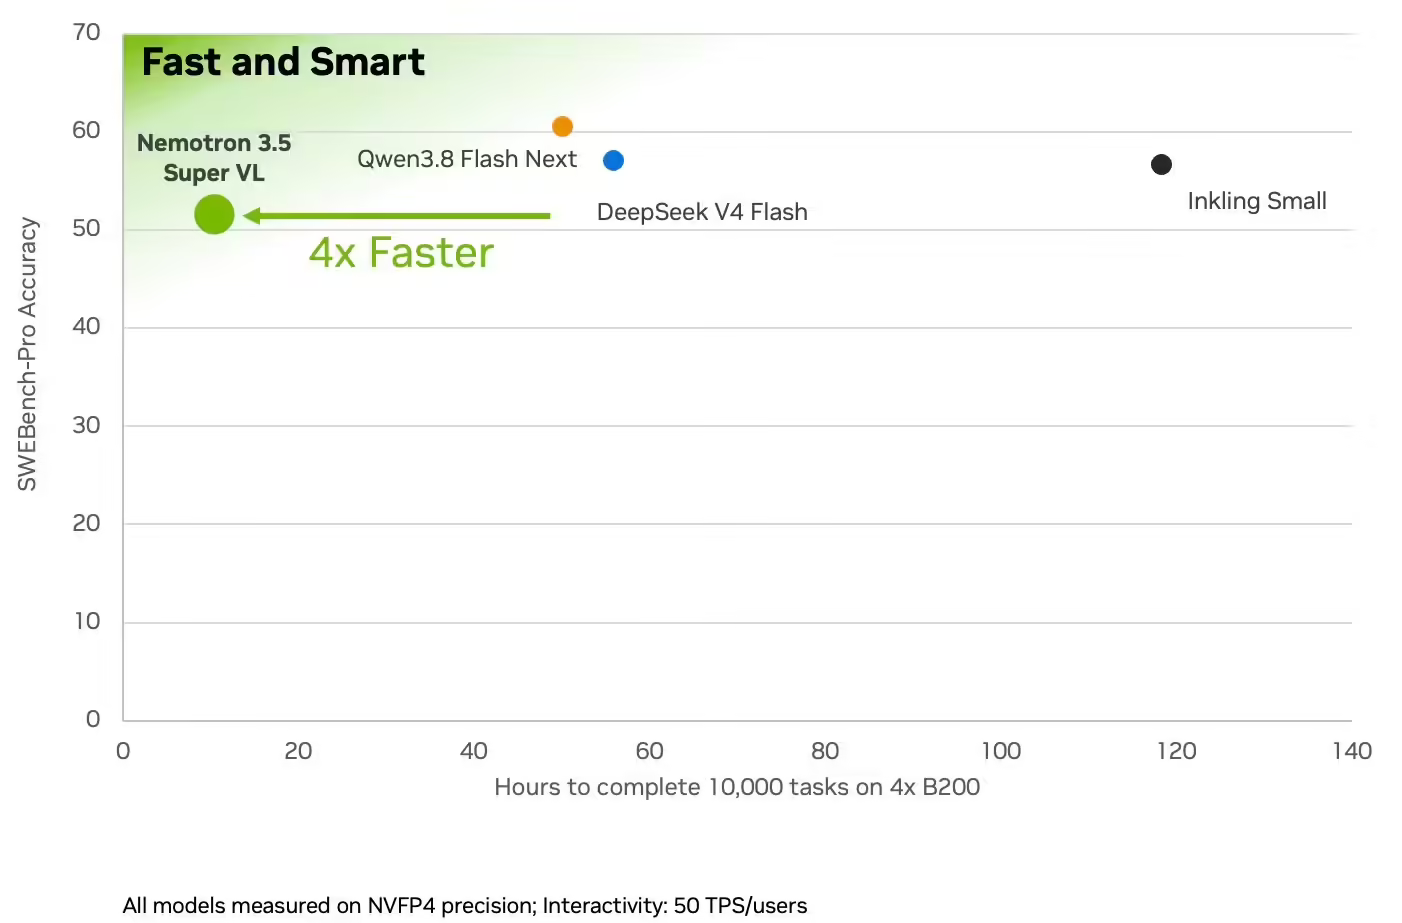
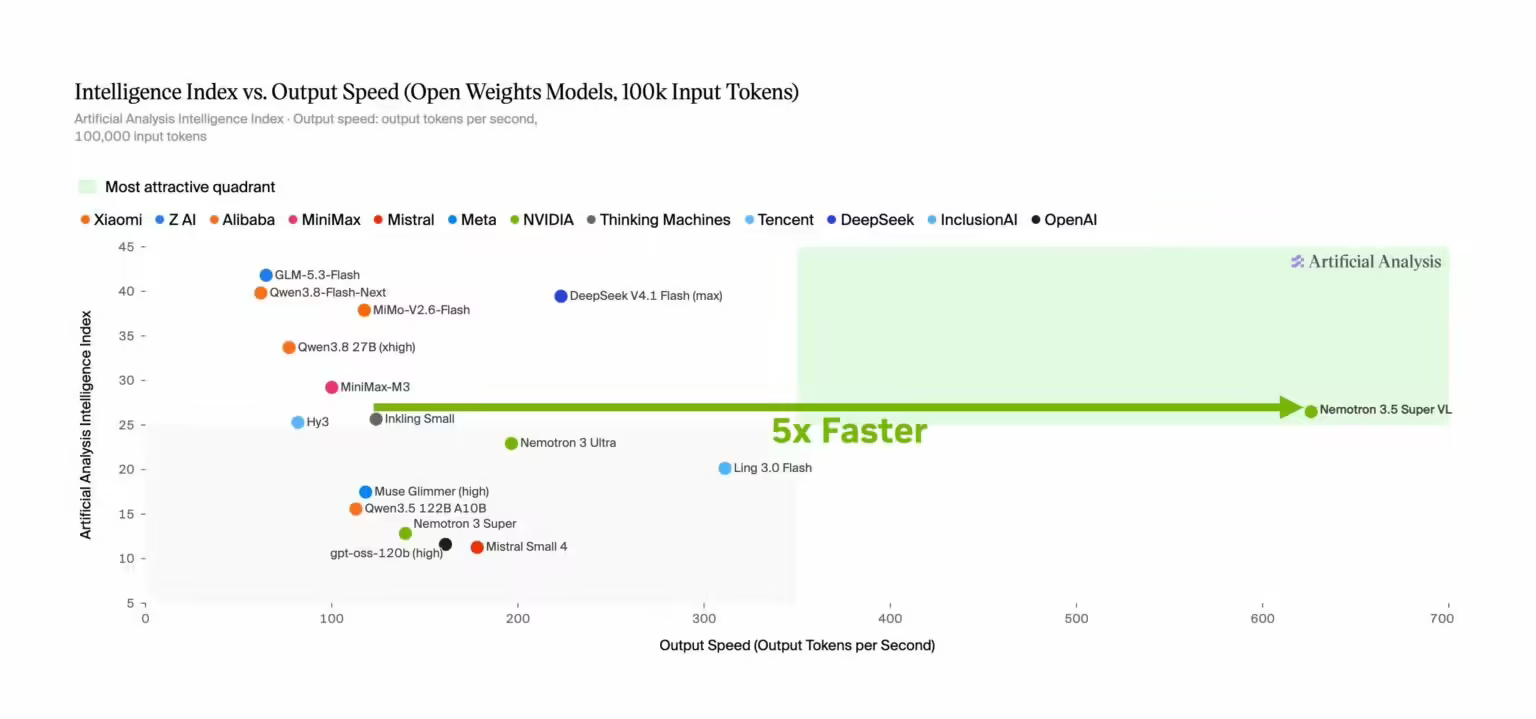
该模型采用混合专家(MoE)架构,总参数量达1200亿,推理时仅激活约120亿参数。英伟达表示,在单张GPU上运行典型智能体工作负载时,其吞吐量最高可达同规模其他开源模型的5倍。
Nemotron 3.5 Super VL 首次将高级推理、精准指令遵循、工具调用能力,与跨模态理解能力(涵盖文本、图像、PDF/扫描文档及短视频)深度集成于统一架构中,适用于代码测试与调试、跨站信息检索、结构化文档分析、网络安全威胁识别、视频内容语义检索等高价值场景。开发者可借助英伟达NeMo工具链,结合自有数据、业务工具、合规策略与工作流,对模型进行高效后训练与行为定制。
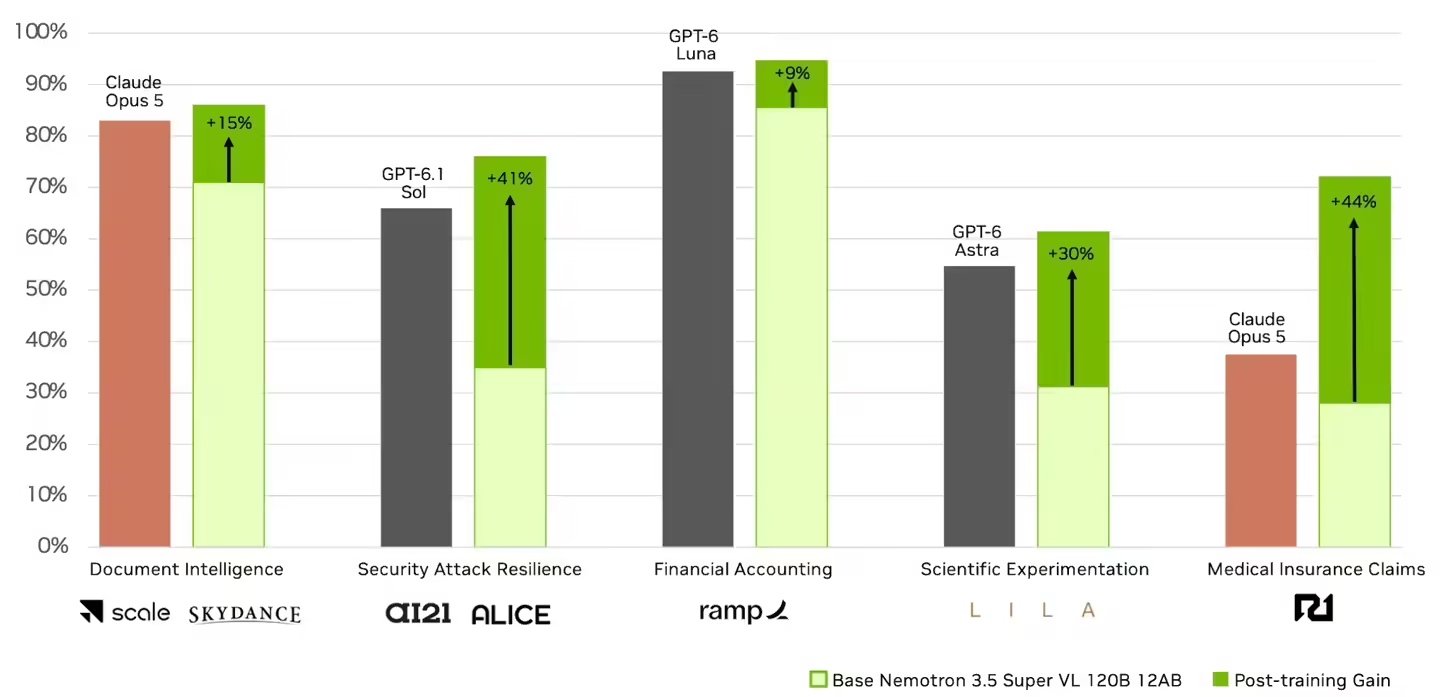
英伟达同步公布了多个企业级落地案例:AI数据服务商Scale AI为影视公司Skydance定制供应商信用处理智能体,预计推理成本降低97.5%,端到端延迟下降80%;金融运营平台Ramp利用该模型将收据图像解析为结构化JSON(含商户、日期、金额等字段),吞吐量提升最高达50%,延迟减少90%;AI21联合安全公司Alice打造的威胁情报分析模型,在漏洞识别任务中准确率提升40%。
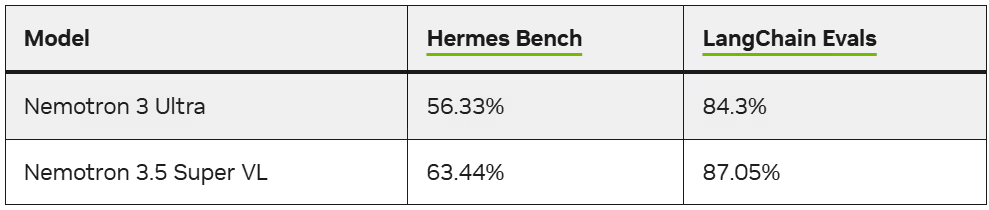
在权威基准评测中,Nemotron 3.5 Super VL表现突出:在CharXiv图表推理基准中得分80.8%(显著高于前代Nemotron 3 Nano Omni的63%),接入Python代码解释器后进一步跃升至84%;在Hermes Bench和LangChain行为评估中分别取得63.44%与87.05%的成绩,均优于Nemotron 3 Ultra;同时跻身OCRBench v2榜单前列,是当前表现最优异的开源多模态模型之一。
为显著降低推理开销,模型集成多项前沿优化技术,包括英伟达自研的LiLiCorr投机解码(在DGX Spark平台下词元生成速度最高提升2.3倍)、混合精度计算与上下文复用机制。
模型全面支持NVFP4量化:在Blackwell架构GPU上采用4位权重+4位激活;在非Blackwell平台则兼容4位权重+16位激活,兼顾性能与部署灵活性。
针对分布式推理场景,英伟达推出NVIDIA Dynamo优化方案——在16张B200 GPU、每用户50 tokens/sec的负载下,配合缓存感知路由、会话亲和性与KV缓存卸载技术,系统并发用户容量提升至8倍,首词元延迟降低85%。
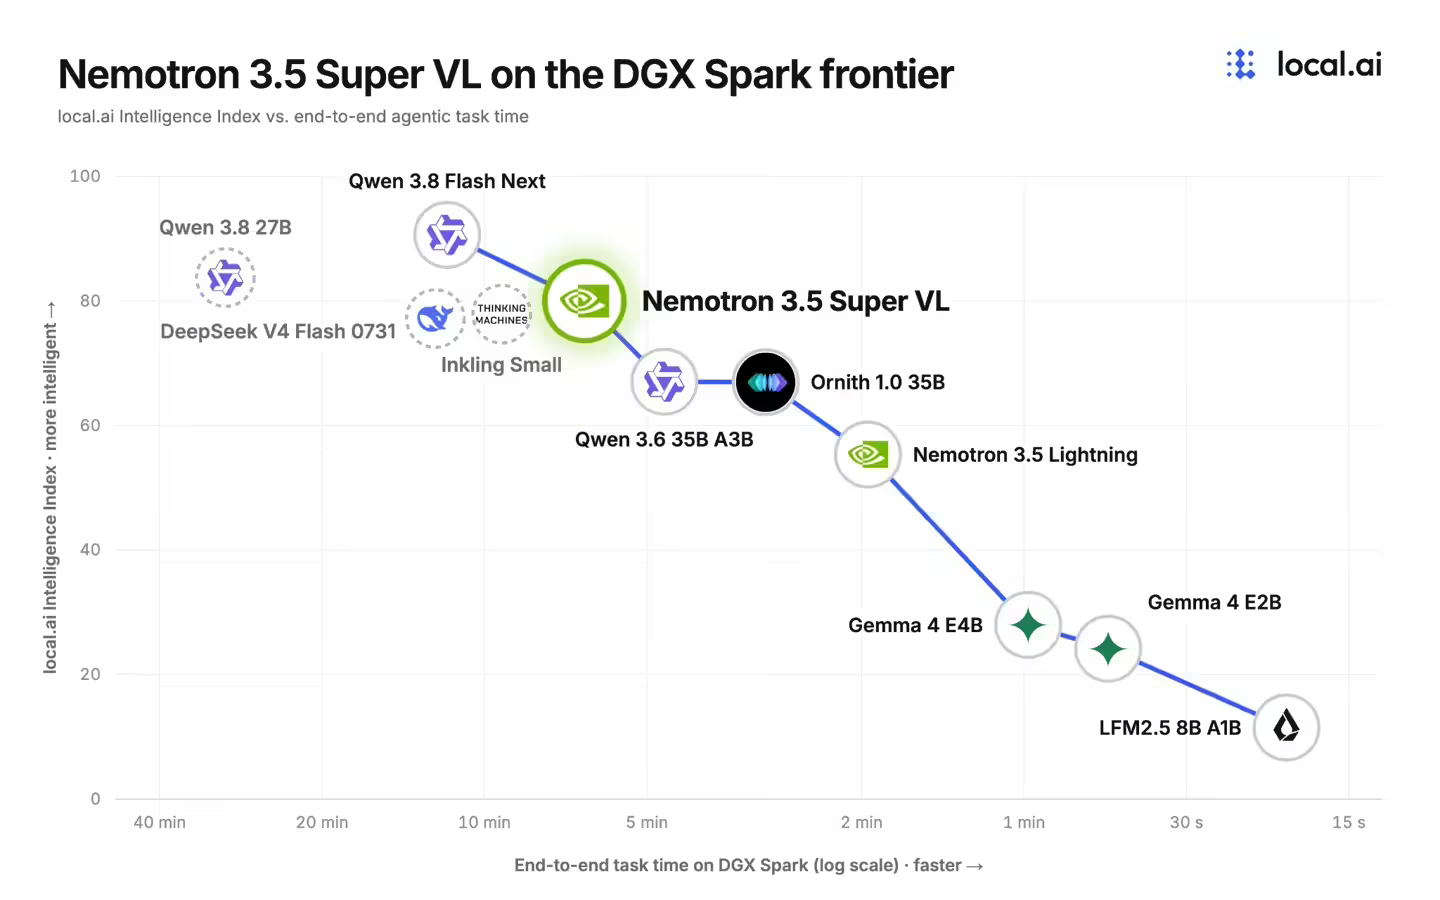
本次发布完整开源模型权重(含基础版、后训练版及NVFP4量化版),并同步公开训练配方、多样化数据集及强化学习环境。据披露,模型在预训练与持续预训练阶段共消耗约26万亿词元,后训练使用380万高质量样本,并在数十类仿真与真实环境中完成强化学习微调。新增开放数据集覆盖智能体工具调用、金融逻辑推理、长上下文理解、公平性评估及视觉-语言联合建模等关键方向。
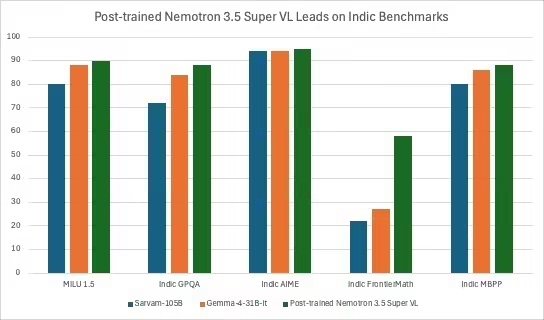
除Super VL外,英伟达同步推出两款面向终端侧的Nemotron 3.5 Bolt轻量模型:74B-A9B 24GB版本采用740亿总参数、90亿激活参数的MoE架构,通过原生2位量化压缩至24GB,适配本地智能体任务,原生支持llama.cpp、vLLM、Ollama、Unsloth与LM Studio;E4B 4GB版本则专为语音助手、交互式数字人及嵌入式界面等资源受限场景设计,将于10月23日正式发布。
Nemotron 3.5 Super VL与Bolt 74B-A9B 24GB模型即日起开放下载,开发者可通过Hugging Face、OpenRouter、ModelScope等主流平台获取。Super VL支持部署于DGX Spark、DGX Station、RTX工作站、数据中心及主流云平台;Bolt E4B 4GB版本将于10月23日上线。