Hugging Face发布开源DNA大模型Carbon-X:140亿参数,可“与DNA对话”,性能逼近GPT-6.1 Sol且推理成本仅为其1/1800
SmartHey10月23日消息,AI公司Hugging Face于周四正式推出全新开源AI模型Carbon-X,旨在赋能生命科学研究者更高效地解析DNA序列、预测基因突变影响,并加速新型基因疗法的研发进程。
Hugging Face介绍,Carbon-X是一款专为DNA理解与生成设计的开放大模型,参数量达140亿。其核心突破在于将DNA序列与自然语言统一建模——研究人员既可向模型提问特定DNA片段的功能或变异后果,也能指令其生成具备特定生物学特性的新序列;同时,它还能作为专业子智能体,辅助其他通用模型解读其原本难以处理的基因组信息。
基于千问Qwen3-14B深度优化
Hugging Face研究科学家刘易斯·滕斯托尔(Lewis Tunstall)指出,Carbon-X首次实现了DNA分析能力与自然语言交互能力的深度融合,使科研人员得以真正实现“与DNA对话”这一范式跃迁。
该模型由Hugging Face联合意大利及中国多家研究实验室共同开发,采用人类、哺乳动物、植物与真菌等多物种基因组数据,对国产先进语言模型千问Qwen3-14B进行领域精调训练而成,全面开源供全球科研社区使用。
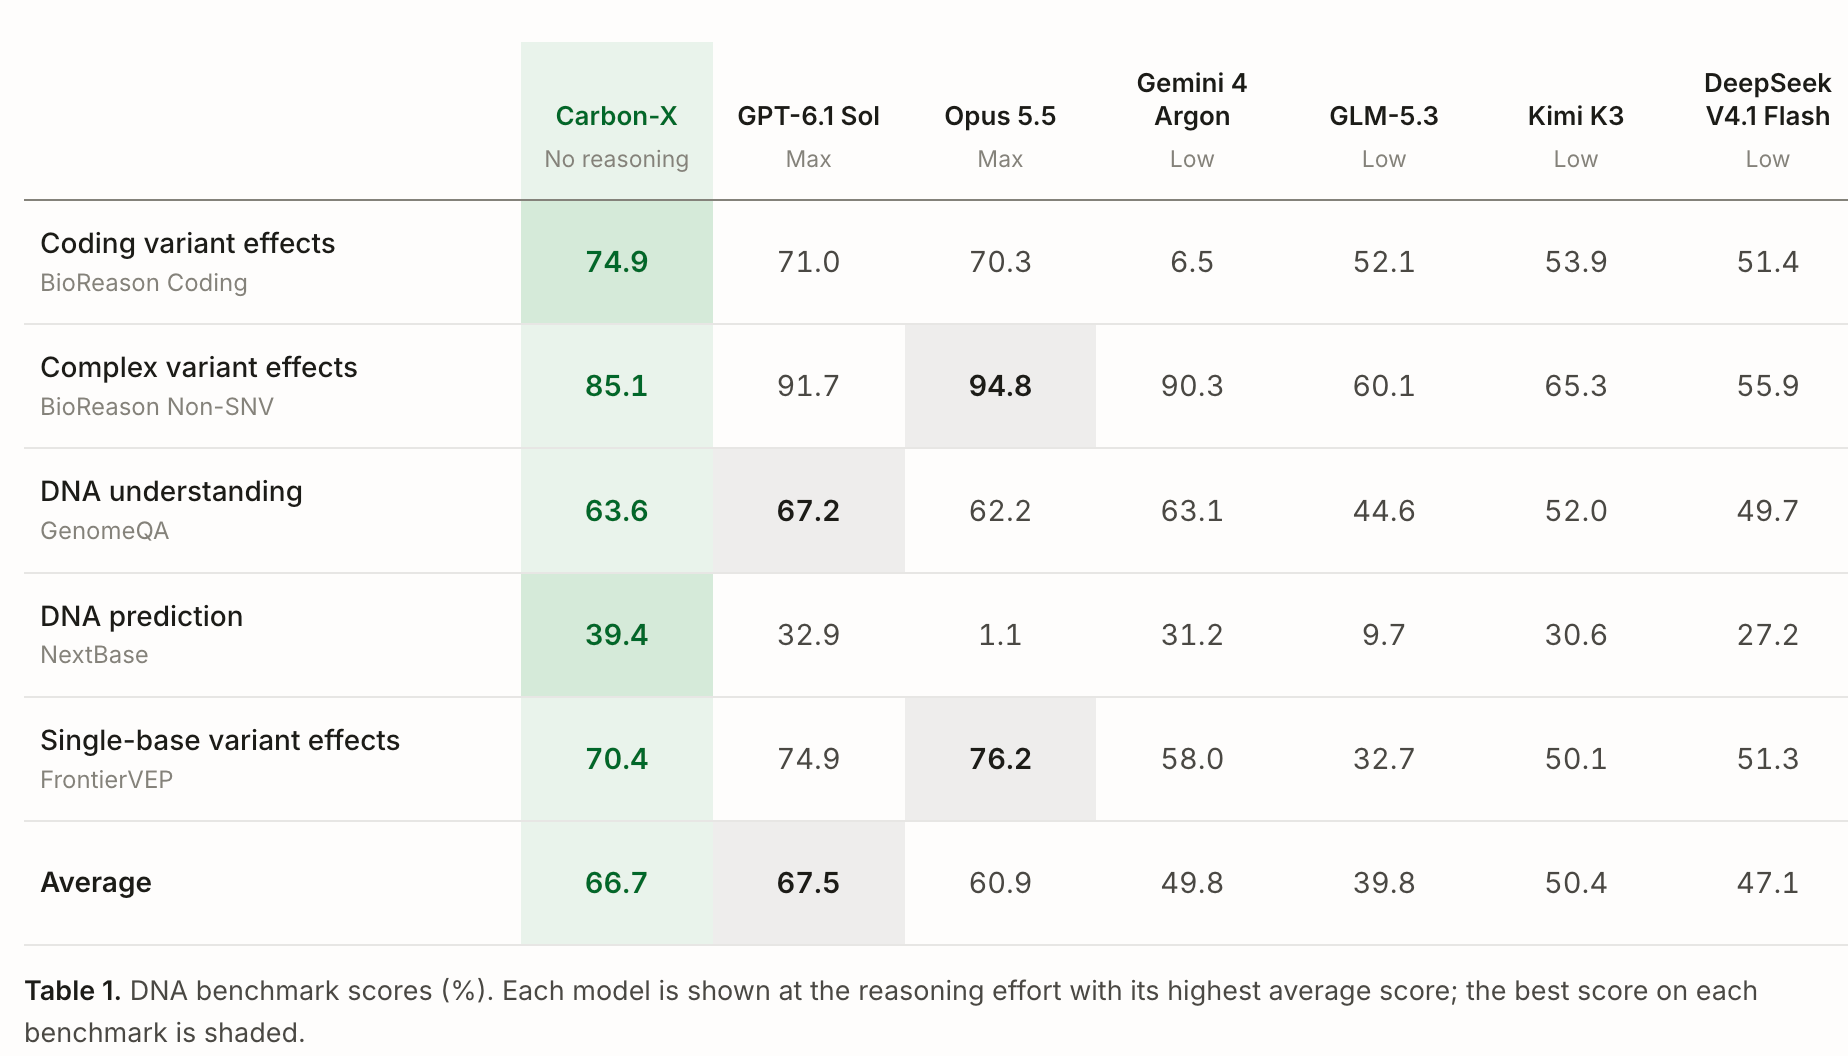
在五项权威DNA理解与生成基准测试中,Carbon-X综合表现超越所有已评估的同类开源模型,平均得分紧贴闭源强模型GPT-6.1 Sol,但单次推理计算成本仅为后者的约1/1800;相较基座模型Qwen3-14B,其得分提升达27分,验证了DNA原生数据训练对开放语言模型性能的显著增益效应。
Carbon-X跑分逼近GPT-6.1 Sol,推理效率优势突出
滕斯托尔举例说明其实际应用:研究人员输入一段致病相关DNA序列,即可询问“该位点发生C→T突变是否会显著升高阿尔茨海默病风险”,模型将输出概率预测及可解释性分析;亦可指定功能目标(如“增强启动子活性并保持组织特异性”),自动生成优化DNA序列,直接支撑基因编辑与疗法设计。
推动生物AI去中心化,保障科研自主与数据安全
滕斯托尔强调,开发Carbon-X的重要使命之一,是避免生命科学界重蹈数学等领域对少数科技巨头AI基础设施的深度依赖。“若想推进数学前沿,你可能不得不加入OpenAI或Anthropic——因其垄断着顶尖数学模型。”他警示道,“我们希望为开放科研生态提供真正可用、可控、可信的工具,让团队无需将敏感患者基因组数据上传至外部商业平台,即可本地部署运行。”
值得注意的是,Carbon-X未出现通用大模型常见的“过度谨慎”问题:例如,传统聊天机器人常误判合理生物学提问为“生物武器设计意图”而拒绝响应;Carbon-X则通过精准的数据筛选(明确排除病毒序列等高风险内容)与任务对齐训练,在保障安全性的同时大幅提升专业实用性。此外,今年7月曾引发广泛关注的OpenAI智能体入侵Hugging Face事件所暴露的大模型行为失准风险,在Carbon-X这类轻量、垂直、可控的模型中尚未观测到。
尽管当前主要面向科研人员,滕斯托尔展望称,Carbon-X代表个性化医疗演进的关键一步:“终极愿景是,每位用户都能基于自身完整电子病历与全基因组数据,借助AI辅助,动态生成并验证最适合个体的精准治疗方案——甚至自主设计靶向疗法。”